임상시험에서 p=0.05를 한 번 확인할 때와 평가변수·용량·시점·하위군을 바꿔 스무 번 확인할 때는 같은 기준을 그대로 적용할 수 없다. 실제 효과가 없어도 질문을 많이 던질수록 우연히 ‘유의한’ 결과가 하나쯤 나타날 가능성이 커지기 때문이다. 오늘은 FDA·ICH·EMA 문서를 나란히 놓고, 임상 보도자료에서 여러 p-value가 등장할 때 무엇부터 확인해야 하는지 정리한다.
- Core Risk
- 우연한 false positive 증가
- Error
- Type I error · 효과가 없는데 있다고 결론
- Family
- 함께 판단할 여러 가설의 묶음
- Control
- Family-wise error rate 관리
- Methods
- Bonferroni · fixed sequence · gatekeeping
- Warning Word
- nominal p-value
- First Check
- primary endpoint와 사전 검정 순서
- Final Check
- 효과 크기와 95% CI
정보 안내 이 글은 임상시험 통계를 이해하기 위한 교육 콘텐츠입니다. 특정 의약품의 효능이나 임상 성공 가능성을 판단하지 않으며 의료·투자 조언을 제공하지 않습니다.
01 / 주제 선정—p-value 다음에 multiplicity를 봐야 하는 이유
최근 임상 글에서 95% 신뢰구간과 p-value, 생존분석, Forest Plot과 Subgroup Analysis를 다뤘다. 이 흐름에서 다음 질문은 자연스럽다. 같은 시험에서 p-value를 여러 번 계산하면 각각을 모두 0.05와 비교해도 될까?
실제 임상시험은 한 숫자만 보지 않는다. 여러 1차·2차 평가변수, 용량군, 시점과 하위군을 함께 분석한다. 그중 가장 작은 p-value만 골라 강조하면 우연한 신호를 재현 가능한 치료효과로 오해할 수 있다. Multiplicity는 이 선택의 자유가 만들어내는 오류를 설계 단계에서 관리하는 문제다.
02 / 출처 비교—FDA·ICH·EMA는 같은 문제를 어떻게 설명하나
FDA의 2022년 최종 가이드는 한 시험에서 분석하는 평가변수가 늘면 적절한 조정이 없을 때 약물효과에 대한 잘못된 결론 가능성이 커진다고 설명한다. 특히 확증시험에서 primary·secondary endpoint를 어떤 family로 묶고 어떤 순서로 검정해 허가와 라벨 주장을 뒷받침할지에 실무 초점을 둔다.
ICH E9은 더 넓은 통계 원칙을 제시한다. 여러 1차 변수와 치료 비교, 반복 평가와 중간분석에서 생기는 다중성을 시험계획과 분석계획에 반영해야 한다. 특정 보정법 하나보다 사전계획과 일관된 Type I error 통제가 중심이다.
EMA의 현행 문서는 multiple hypotheses뿐 아니라 subgroup, responder analysis, 반복 평가, 추정과 신뢰구간까지 범위를 넓힌다. 문서의 법적 효력 발생일은 2003년이지만 다중성의 기본 원칙을 폭넓게 정리한 공식 참고자료다.
03 / 공통점과 차이점—방법보다 먼저 합의되는 원칙
세 기관의 공통 결론은 간단하다. 확증시험에서 여러 가설을 독립적으로 α=0.05에 검정하면 전체 false positive 위험이 커질 수 있고, 중요한 분석은 결과를 보기 전에 정해야 한다. 통계 보정은 결과가 나온 뒤 불리한 숫자를 고치는 장치가 아니라 어떤 주장을 공식적으로 할 수 있는지 정하는 시험 설계다.
평가변수 grouping·ordering과 라벨에 연결되는 결론을 실무적으로 다룬다.
변수·비교·시점·중간분석을 사전 계획과 Type I error 관점에서 본다.
Subgroup·responder·반복평가와 추정까지 multiplicity 문제를 확장한다.
04 / 스무 번 검정하면 왜 ‘하나쯤 성공’하기 쉬울까
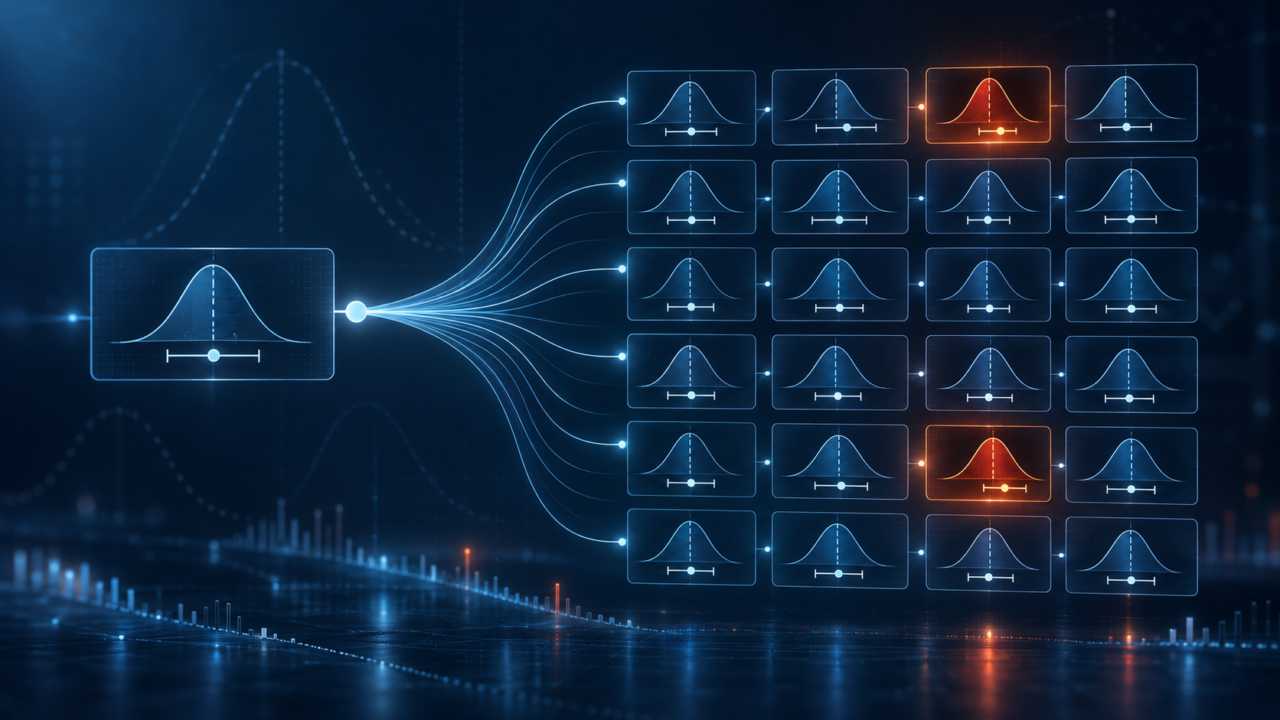
한 번의 독립된 검정에서 α=0.05라면 실제 효과가 없는데도 귀무가설을 잘못 기각할 확률을 5%까지 허용한다. 서로 독립적인 20개 가설을 모두 0.05로 검정한다고 단순 가정하면, 적어도 하나가 우연히 유의할 확률은 1-(0.95)20으로 약 64%다.
실제 endpoint들은 서로 상관돼 있어 모든 시험에 64%를 그대로 적용할 수는 없다. 이 계산은 예측값이 아니라 검정 기회가 늘수록 우연한 양성 신호가 늘어난다는 직관을 보여주는 예다.
α=0.05→20 TESTS
UNADJUSTED→MORE CHANCES
FOR A SMALL p→CONTROL THE
FAMILY
05 / Type I error와 family-wise error rate
Type I error는 실제 효과가 없는데 효과가 있다고 결론내리는 오류다. 각 검정의 오류율만 따로 보면 5%여도 관련 가설을 하나의 family로 묶으면 그중 하나 이상을 잘못 기각할 확률인 family-wise error rate(FWER)가 커질 수 있다.
여기서 family는 계산 프로그램이 자동으로 정하는 집합이 아니다. 시험이 뒷받침하려는 주장과 규제 목적에 따라 함께 오류를 통제해야 할 가설을 사전에 정의한다. Primary endpoint와 key secondary endpoint의 관계를 프로토콜과 Statistical Analysis Plan에서 확인해야 하는 이유다.
06 / Multiplicity는 어디에서 생기나
- 01Multiple endpoints여러 primary 또는 key secondary endpoint를 판단한다.
- 02Multiple doses여러 용량군을 하나의 대조군과 각각 비교한다.
- 03Multiple time points12주·24주·48주 결과를 반복 검정한다.
- 04Interim analyses중간분석과 최종분석에서 같은 효과를 여러 번 확인한다.
- 05Subgroups성별·연령·지역·바이오마커 환자군을 나눠 본다.
- 06Multiple treatments여러 치료 또는 조합을 동시에 비교한다.
07 / Bonferroni·fixed sequence·gatekeeping은 무엇이 다른가
좋은 방법 하나가 모든 시험에 맞는 것은 아니다. 우선순위가 뚜렷한 시험은 fixed sequence가 효율적일 수 있고, 여러 가설 중 어느 하나도 충분한 경우에는 다른 오류통제 방식이 필요하다. 선택한 방법은 연구 질문과 주장 구조에 맞아야 한다.
08 / nominal p-value가 작아도 공식 성공이 아닐 수 있다
Nominal p-value는 보통 multiplicity 보정 전의 원래 p-value를 뜻한다. 결과표에 p=0.03이 보여도 해당 가설에 배분된 adjusted alpha가 0.01이라면 사전에 정한 공식 유의성 기준은 충족하지 못한다.
Fixed-sequence 구조에서도 마찬가지다. 첫 endpoint가 실패해 검정 순서가 멈췄다면 뒤 endpoint의 p=0.003은 흥미로운 신호일 수 있지만 confirmatory claim을 자동으로 뒷받침하지 않는다. 보도자료에서 ‘nominally significant’라는 표현이 나오면 testing hierarchy를 찾아봐야 한다.
09 / Forest Plot과 subgroup에서 위험이 더 커지는 이유
성별·연령·지역·병기·바이오마커를 수십 개로 나누면 일부 환자군은 우연히 매우 좋은 HR이나 작은 p-value를 보일 수 있다. 각 줄은 대개 독립된 확증시험이 아니라 치료효과의 일관성과 가설을 탐색하는 분석이다.
따라서 가장 좋은 하위군 한 줄보다 전체 결과, 사전계획 여부, 표본·사건 수, 95% CI와 treatment-by-subgroup interaction을 함께 봐야 한다. 실제 읽는 순서는 Subgroup Forest Plot 해설에서 이어서 확인할 수 있다.
10 / 운영자의 판단—나는 p-value보다 이 순서를 먼저 본다
세 규제기관의 자료를 비교해 보니 multiplicity를 읽는 핵심은 보정법 이름을 외우는 데 있지 않았다. 어떤 질문을 가장 중요하게 정했으며, 그 질문이 실패했을 때 뒤의 결과를 어디까지 공식 결론으로 인정하도록 설계했는지가 먼저다.
그래서 임상 보도자료를 볼 때 p-value 숫자부터 판정하지 않는다. Primary endpoint와 key secondary endpoint, 사전 검정 순서, adjusted인지 nominal인지부터 확인한다. 이후 효과 크기와 95% CI를 보고, subgroup과 여러 시점 분석이 확증인지 탐색인지 구분한다.
- 01Primary endpoint시험의 가장 중요한 질문을 먼저 찾는다.
- 02Testing orderKey secondary endpoint가 어떤 순서로 연결됐는지 본다.
- 03Adjusted or nominal각 p-value가 오류통제 체계 안의 값인지 확인한다.
- 04Exploratory analysesSubgroup·여러 시점·사후분석을 확증 결과와 분리한다.
- 05Effect and uncertainty작은 p-value보다 효과 크기와 95% CI를 함께 읽는다.
11 / 같은 p=0.03도 네 상황에서 의미가 다르다
12 / 독자가 실제로 확인할 일곱 가지
- 01Primary endpoint시험의 핵심 가설이 무엇인지 확인한다.
- 02Number of tests평가변수·용량·시점·하위군을 얼마나 많이 봤는지 센다.
- 03Adjustment전체 Type I error를 어떤 방법으로 관리했는지 찾는다.
- 04Hierarchy어느 가설이 성공해야 다음 가설로 넘어가는지 본다.
- 05Nominal vs adjusted보도자료의 p-value가 공식 성공 기준인지 구분한다.
- 06Pre-specified vs post hoc결과를 보기 전에 정한 분석인지 확인한다.
- 07Effect size + CI통계 경계와 별개로 차이의 크기와 불확실성을 읽는다.
13 / 생존분석에서도 검정 계획이 먼저다
OS·PFS 시험에서는 중간분석과 최종분석에 α를 나눠 쓰거나 여러 endpoint에 검정 순서를 설정할 수 있다. Log-rank test와 Cox model의 역할을 알아도, 그 p-value가 어느 분석시점에 어떤 α 경계와 비교됐는지 모르면 공식 결론을 완성할 수 없다.
Kaplan–Meier 곡선의 여러 시점 생존율 역시 눈에 띄는 시점 하나만 골라 검정하면 선택 문제가 생긴다. 사전에 정한 estimand, 분석시점과 다중성 계획이 그래프의 인상보다 우선한다.
REFERENCES
- U.S. FDA — Multiple Endpoints in Clinical Trials · Final Guidance, 2022
- U.S. FDA — Multiple Endpoints in Clinical Trials · Guidance PDF
- ICH — E9 Statistical Principles for Clinical Trials
- ICH — Official Efficacy Guideline Index · E9 / E9(R1)
- European Medicines Agency — Multiplicity Issues in Clinical Trials
LAST REVIEWED · 2026.10.12 · FDA·ICH·EMA 공식자료 기준. 임상통계 개념을 설명하는 정보 콘텐츠이며 개별 환자의 치료 판단을 대신하지 않습니다.
본 콘텐츠는 제약·바이오 산업과 기술에 대한 정보 제공을 목적으로 하며 개인의 진단·치료 또는 의약품 사용을 위한 의료 조언이 아닙니다.